KI-Infrastruktur: NVIDIAs „heimliche Steuer“ und die Rebellion der Giganten
1. Einleitung: Das teuerste Wettrennen der Geschichte
Wir befinden uns inmitten einer beispiellosen physikalischen Materialschlacht, die die Grenzen der globalen Infrastruktur sprengt. Das „Stargate"-Projekt - ein von OpenAI, Softbank und Oracle initiiertes Mega-Rechenzentrum - verdeutlicht diese neuen Dimensionen: Mit einem geplanten Budget von 500 Milliarden USD und einem Ziel von 400.000 High-End-GPUs sowie einem Strombedarf von 1,2 Gigawatt (vergleichbar mit einer mittelgroßen Stadt) übersteigt dieses Vorhaben jede bisherige IT-Investition.„Das Budget für das Stargate-Projekt entspricht in etwa dem gesamten Bruttoinlandsprodukt (BIP) von Thailand."Diese Summe ist nur der Vorbote eines massiven Kapitalzyklus. Die kumulierten Investitionen der führenden Hyperscaler werden bis 2026 voraussichtlich auf 690 Milliarden USD steigen. Als Analyst stellt sich die Frage: Ist dies eine spekulative Blase oder die notwendige Skalierung einer neuen industriellen Basis? Die Antwort liegt in der Erkenntnis, dass Rechenleistung die neue harte Währung der Weltwirtschaft ist.
2. Takeaway 1: Von der Software-Optimierung zum physischen Ressourcenkrieg
Das Zeitalter, in dem kluger Code allein über den Markterfolg entschied, ist vorbei. Das neue Dogma lautet: „Intelligence is computable". Wer die physischen Ressourcen kontrolliert, definiert die technologische Vorherrschaft.
- Das Gefangenendilemma der Giganten: In der Entwicklung der Artificial General Intelligence (AGI) ist der Zweite der erste Verlierer. Ein technischer Rückstand bei GPT-5 - das schätzungsweise die 10- bis 100-fache Rechenleistung von GPT-4 erfordert - würde Geschäftsmodelle in den Bereichen Suche und SaaS über Nacht entwerten.
- Rechenleistung als Landreserve: Für Cloud-Anbieter sind GPU-Cluster die „Landreserven" des 21. Jahrhunderts. Wer heute keine Kapazitäten sichert, besitzt in zwei Jahren nicht einmal mehr die „Eintrittskarte" zum Wettbewerb.
- Die neue Rolle der CPU: Mit dem Aufstieg von „AI Agents", die komplexe, mehrstufige Entscheidungen treffen (z. B. Reisebuchungen), wandelt sich die CPU vom bloßen Datenlieferanten zum strategischen Orchestrator. Diese „Value Re-evaluation" führt dazu, dass die CPU wieder an Bedeutung gewinnt, um die komplexen Logikketten hinter den GPU-Berechnungen zu steuern.
3. Takeaway 2: Die „NVIDIA-Steuer" und die Rebellion der Cloud-Giganten
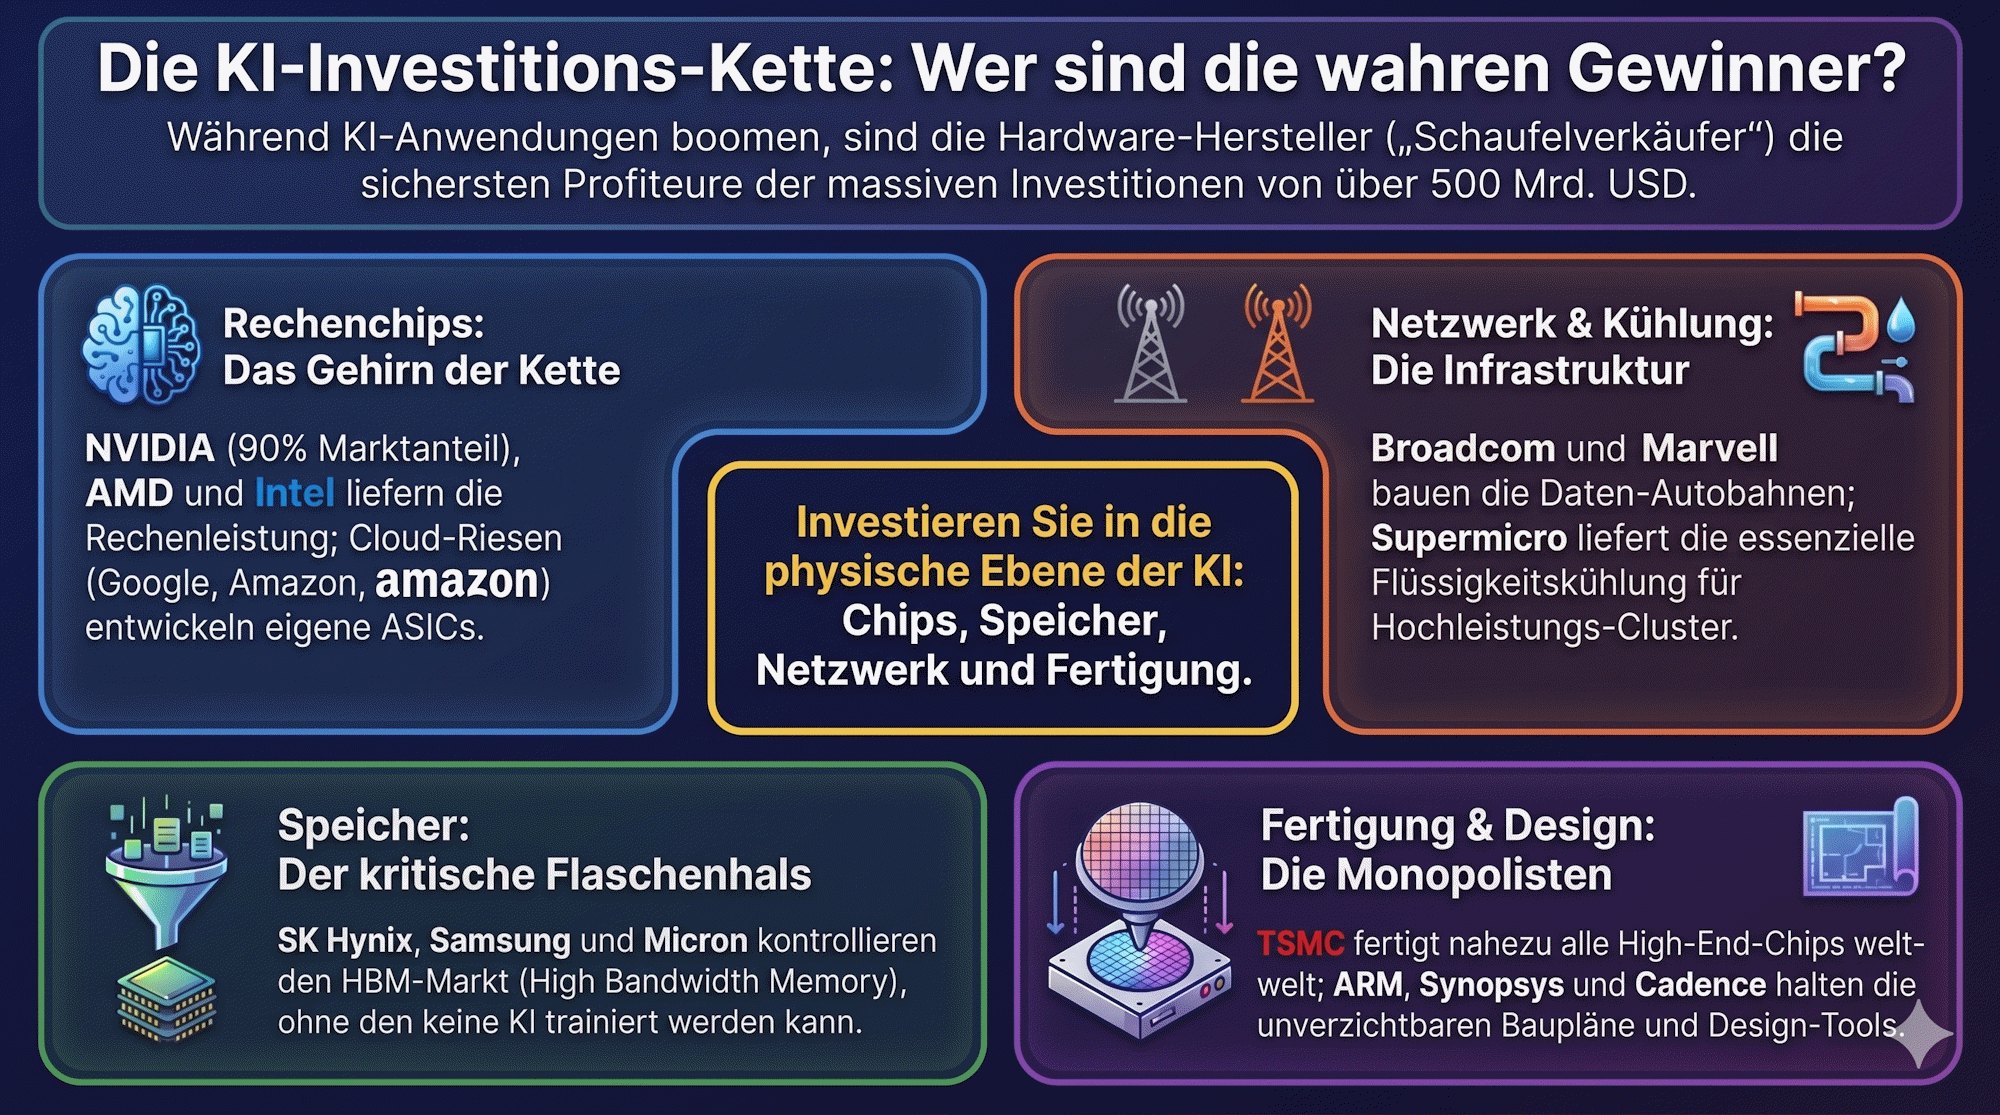
NVIDIA hält mit einem Marktanteil von über 90 % bei Trainings-Chips ein faktisches Monopol. Der „Moat" ist hierbei nicht nur die Hardware, sondern das CUDA-Ökosystem - das „Windows der KI". Ingenieure meiden den Wechsel zu Konkurrenten, da die Portierung von Code Monate an Debugging-Zeit kosten würde. Doch der Widerstand formiert sich:
- Der ASIC-Gegenangriff: Google (TPU) und Microsoft (Maia) setzen massiv auf anwendungsspezifische Chips, die unnötigen Ballast abwerfen und bei stabilen Algorithmen die Kosten pro Inferenz halbieren.
- NVIDIAs brillanter Konter: NVIDIA reagiert auf die ASIC-Rebellion mit einer „Interconnect-Steuer". Durch strategische Investitionen in ASIC-Enabler wie Marvell (die „Hired Guns" der Cloud-Riesen) forciert NVIDIA die „NVLink Fusion"-Architektur. Das Kalkül: Auch wenn die Cloud-Riesen eigene Chips bauen, sollen sie weiterhin NVIDIAs proprietäre Netzwerk-Infrastruktur nutzen. Wer die Verbindung kontrolliert, kassiert die Maut, unabhängig vom Chip-Design.
4. Takeaway 3: Die „Memory Wall" - Warum HBM der wahre Flaschenhals ist
Der schnellste Prozessor ist nutzlos, wenn er in einer „Daten-Hungersnot" verharrt. High Bandwidth Memory (HBM) ist das kritische Nadelöhr (die „Memory Wall"). Während GPUs die Rechenarbeiter sind, fungiert HBM als der hochspezialisierte „Ziegelträger", der Daten mit extremer Bandbreite anliefert.
- IDM-Manufacturing Barriers: Im Gegensatz zu Logikchips kann HBM nicht einfach bei TSMC in Auftrag gegeben werden. Es ist ein „Handwerk" (Craft), das Jahrzehnte an IDM-Erfahrung (Integrated Device Manufacturer) erfordert.
- Strategische Knappheit: Nur ein Trio (SK Hynix, Samsung, Micron) beherrscht die extrem engen Fertigungsfenster. Für Konkurrenten, insbesondere aus China, bedeutet dies einen technologischen Rückstand von zwei bis drei Generationen, der sich kaum durch bloßes Kapital aufholen lässt. HBM ist derzeit die knappste Ressource im gesamten KI-Ökosystem.
5. Takeaway 4: Das Ende des Servers - Wenn der Schrank zur Single-GPU wird
Mit der Blackwell-Architektur (NVL72) erleben wir den Übergang von „Scale-Out" (viele vernetzte Server) zu „Scale-Up" (ein ganzer Schrank als eine Einheit).
- Die 130 TB/s Revolution: Während in der H100-Ära das Scale-Up-Limit bei 8 GPUs lag, lässt das NVL72-System 72 GPUs für das Modell wie einen einzigen, gigantischen Chip erscheinen. Die Bandbreitendichte erreicht dabei astronomische 130 Terabyte pro Sekunde.
- Latent-Free Intra-Rack Communication: Um die Latenzen der optischen Umwandlung zu eliminieren, kehrt NVIDIA zu Kupfer zurück. Der „NVLink-Spine" im Schrank besteht aus über 5.000 Kupferkabeln (35 kg Gewicht). Ziel ist die Schaffung eines „Super-Gehirns", statt eines losen Verbunds kleinerer Einheiten. Das Verhältnis von GPUs zu 1,6T-Transceivern von 1:2 bis 1:3 unterstreicht den enormen Vernetzungsaufwand.
6. Takeaway 5: Flüssigkühlung ist kein Luxus mehr, sondern eine Überlebensfrage
Ein einzelner H100-Knoten verbraucht 10 kWh - herkömmliche Luftkühlung ist bei dieser Leistungsdichte physikalisch am Ende. In einem Standard-Rack könnten ohne radikale Maßnahmen nur vier Server betrieben werden, bevor die Hardware thermisch kollabiert.
- Thermische Kompression: Flüssigkühlung ist die einzige Lösung, um die Rechnerdichte pro Quadratmeter zu verdoppeln. Elon Musks XAI-Zentrum demonstriert dies eindrucksvoll durch die Integration von 64 H100-Chips in einem einzigen, flüssigkeitsgekühlten Rack.„Flüssigkühlung ist im KI-Zeitalter weit mehr als nur Kühlung; sie ist die strategische Kompression von physischem Raum und damit der entscheidende Hebel für die Wirtschaftlichkeit der Rechenfabrik."Durch den Wegfall massiver Lüftersysteme und die Verringerung der Stellfläche werden die immensen Baukosten für die physischen Hüllen der Rechenzentren drastisch reduziert.
7. Fazit: Werden wir die „Rechen-Steuer" jemals los?
Momentan sind die „Schaufelverkäufer" - NVIDIA für die Logik, das HBM-Trio für den Speicher und Spezialisten für die thermische Infrastruktur - die garantierten Profiteure. Doch der Markt steht vor einer Verschiebung: Während heute das Training dominiert, wird künftig die Inferenz das Volumen bestimmen. Branchenprognosen gehen davon aus, dass der Anteil von ASICs im Inferenz-Markt von derzeit 10 % auf 40 % bis zum Jahr 2028 steigen wird.Die physische Realität bleibt jedoch der ultimative Schiedsrichter. Wir beobachten eine Transformation von der IT-Architektur hin zur Schwerindustrie.Abschlussfrage: Werden am Ende die unerbittlichen physikalischen Grenzen von Stromnetzen und Kühlkapazitäten das Tempo der KI-Evolution stärker bremsen als der menschliche Erfindungsgeist?
Keine Anlageberatung. Prüfe Informationen und Annahmen eigenständig.